6120 links
  • GuiGui's Show
  • Home
  • Login
  • RSS Feed
  • ATOM Feed
  • Tag cloud
  • Picture wall
  • Daily
Links per page: 20 50 100
◄Older  
page 260 / 306
Newer►
  • 'FREAK' – une faille majeure née de la lutte des US contre le chiffrement
    « "L'agilité du protocole TLS souffre du gonflement de son héritage : après 20 années d'évolutions du standard, celui-ci comporte de nombreuses versions, extensions, et suites de chiffrement, dont certaines ne sont plus utilisées ou connues pour être non-sécurisées" écrivent les chercheurs dans le rapport consacrés aux attaques FREAK. Et cet héritage est justement une des causes de ce nouveau risque de sécurité identifié sur Internet.

    En effet, la multiplication des versions du protocole, des modes d'authentification et des méthodes d'échange de clé permettant d'établir une connexion sécurisée entre un client et un serveur a engendré des "bugs" et "plusieurs vulnérabilités de sécurité critiques". Et ces failles sont demeurées cachées dans "ces libraires pendant des années".

    [...]

    Freak est particulièrement intéressante puisque cette vulnérabilité a pour origine les restrictions à l’export qui ont été mises en place sur la cryptographie dans les années 90. Ces familles d’algorithmes dédiés à l’export étaient plus faibles que les versions classiques aujourd’hui communément utilisées. L’attaque repose sur cela : à cause d’un bug, un attaquant peut exploiter cela et modifier les messages entre le client et le serveur pour forcer l’utilisation de ces familles de chiffrement, initialement destinées à l’export et qui ne garantissent pas une sécurité suffisante. Du côté client, celui-ci croit accepter une connexion sécurisée, mais celle-ci ne l’est pas, en tout cas pas aussi solide que ce qu’il croit.

    Deux conditions sont nécessaires pour que l’attaque soit mise en place : il faut que l’attaquant parvienne à se placer dans un schéma d’attaque de type "Man in the middle", afin d’intercepter les messages échangés entre le client et le serveur, et côté serveur, il faut que celui-ci supporte les familles export d’algorithmes. Cette attaque reste assez délicate à mettre en œuvre puisqu’elle demande des moyens relativement importants : il parait difficile pour un individu visant une entreprise par exemple, d’envisager utiliser une attaque de ce type. C’est en revanche beaucoup plus envisageable pour un attaquant soutenu par un Etat.

    [...]

    D’après des tests réalisés par des experts de l’université du Michigan, un tiers des sites utilisant du chiffrement s’avèrent vulnérables à des attaques FREAK. C’est en particulier le cas de ceux utilisant OpenSSL (un correctif existe) et des clients TLS/SSL d’Apple. D’ailleurs le navigateur Safari de l’éditeur est vulnérable, tout comme celui intégré dans Android. Chrome, Firefox et Internet Explorer ne sont en revanche pas concernés. [ÉDIT du 06/03/2015 à 10h23 : sisi IE est aussi concerné : http://arstechnica.com/security/2015/03/stop-the-presses-https-crippling-freak-bug-affects-windows-after-all/ FIN DE L'ÉDIT.]

    [...]

    l’attaque Freak mais il faut bien comprendre que celle-ci appartient à une famille d’attaques, que nous avons regroupées sous le nom de State Machine Attacks. Toutes ont pour point commun la façon dont les implémentations de TLS gèrent les algorithmes de chiffrement. On a ainsi détaillé sur le site smacktls une autre attaque, qui vise cette fois l’implémentation de TLS au sein de Java, JSSE, et qui repose sur les mêmes principes.  [...] A l’origine, il y a eu un précurseur à cette attaque, nommé Early CCS. C’est cette attaque qui a montré que les messages envoyés au serveur TLS pouvaient être acceptés dans un ordre incorrect. Nous avons donc cherché comment savoir si les states machines étaient implémentées correctement. Pour tester cette hypothèse, Nous avons développé un outil afin de tester des séquences de messages volontairement incorrectes : si l’implémentation est correcte, alors un message d’erreur doit être renvoyé. Nous avons constaté beaucoup de cas ou aucune alerte n’était remontée et nous nous sommes donc interrogés sur l’interprétation à donner. C'est donc en étudiant le code source d’implémentations Open Source de TLS que nous avons découvert ces attaques. »

    Bref, FREAK c'est mort côté client si pas Apple/Android ou en appliquant les patchs si c'est le cas et côté serveur en virant les suites cryptos destinées à l'export (regroupées dans le groupe EXP dans OpenSSL), ce qui devrait être fait depuis longtemps.

    Via http://seenthis.net/messages/348012
    March 5, 2015 at 5:44:26 PM UTC - permalink - http://www.zdnet.fr/actualites/freak-une-faille-majeure-nee-de-la-lutte-des-us-contre-le-chiffrement-39815774.htm
  • La fin du roaming en Europe en passe d'être repoussée à 2018
    « Rappelons que la fin de l'itinérance est une proposition figurant dans le rapport rédigé par l'eurodéputée espagnole Pilar del Castillo et qu'elle a été approuvée par le Parlement européen l'an dernier. L'objectif initial était de faire entrer en vigueur cette mesure le 15 décembre, avec la perspective d'unifier un peu plus le marché intérieur des télécommunications. »

    Huuum... la fin de l'itinérance, c'est dans le même texte que la neutralité des réseaux... De là à dire que le Conseil de l'UE fait traîner l'itinérance pour faire traîner le dossier neutralité des réseaux qui déplaient fortement aux telcos...
    March 5, 2015 at 3:55:55 PM UTC - permalink - http://www.numerama.com/magazine/32392-la-fin-du-roaming-en-europe-en-passe-d-etre-repoussee-a-2018.html
  • Officiel : la censure de Google sur ordre de l'Etat peut commencer !
    « Le Gouvernement a fait publier au Journal Officiel le décret qui autorise ses services de police à demander à Google et d'autres moteurs de recherche ou annuaires le déréférencement de sites accusés de faire l'apologie du terrorisme. Les sites devront être supprimés des index dans les 48 heures, sans possibilités de recours.

    Un mois après le décret autorisant le blocage administratif des sites sur ordre du ministère de l'intérieur, le Gouvernement a fait publier jeudi au Journal Officiel le décret "relatif au déréférencement des sites provoquant à des actes de terrorisme ou en faisant l'apologie et des sites diffusant des images et représentations de mineurs à caractère pornographique".

    Le texte permet à l'Office central de lutte contre la criminalité liée aux technologies de l'information et de la communication (OCLCTIC) de notifier aux moteurs de recherche les sites accusés de relayer la propagande de terroristes, afin qu'ils soient déréférencés sur le champ, sans qu'un juge ne vérifier l'illégalité des sites en cause. Google et ses concurrents auront 48 heures pour prendre "toute mesure utile destinée à faire cesser le référencement de ces adresses", et devront le faire en respectant scrupuleusement "la confidentialité des données qui leur sont ainsi confiées". Pas question, donc, de publier les ordres de censure.

    [...]

    En revanche, alors que le blocage s'accompagne d'une redirection vers un site du ministère de l'intérieur qui fait explique le blocage et indique des voies de recours, rien n'est prévu pour s'opposer au déréférencement, à l'effet dévastateur.

    [...]

    Le déréférencement sur ordre policier des sites de propagande terroriste avait été introduit par un amendement surprise du Gouvernement présenté à la dernière minute, lors des débats sur la loi anti-terrorisme de 2014. Le ministre de l'intérieur Bernard Cazeneuve avait alors expliqué en séance que le dispositif proposé était identique à celui déjà prévu pour les sites d'argent en ligne, ce qui était mensonger. La loi sur les jeux d'argent en ligne prévoit que le déréférencement peut être ordonné par un magistrat, le président du TGI de Paris, et non directement par l'exécutif.

    [...]

    Le terrorisme n'est pas une notion simple à appréhender juridiquement, et n'a d'ailleurs jamais fait l'objet d'un consensus au niveau international. [...] Hélas, les événements récents consécutifs aux attentats de janvier 2015 à Paris ont rappelé que l'Etat avait une vision très large de l'apologie du terrorisme, au mépris de la liberté d'expression. »
    March 5, 2015 at 2:32:32 PM UTC - permalink - http://www.numerama.com/magazine/32395-officiel-la-censure-de-google-sur-ordre-de-l-etat-peut-commencer.html
  • L'accord entre Cisco et la France fustigé par Laure de la Raudière (UMP)
    « Dans une série de questions adressée ce mardi au Premier ministre Manuel Valls, la députée UMP Laure de la Raudière critique durement le partenariat négocié entre Cisco et le gouvernement français, dont elle dénonce l'absence de vision stratégique, et l'incohérence.

    [...]

    Dans une première question, Laure de la Raudière demande au Premier ministre si "la France doit se laisser « acheter » par les géants américains du numérique ou doit-elle au contraire, se transformer à partir de ses forces, notamment les grand groupes du CAC40". Elle fait le parallèle entre les 100 millions d'euros promis par Cisco et les 60 millions d'euros que Google a accepté de payer pour éviter une redevance sur l'indexation de la presse. L'élue d'Eure-et-Loir veut "savoir comment le partenariat avec Cisco s'inscrit dans l'objectif de transformation numérique de nos grands groupes ou dans la création de nouveaux grands groupes français de l'industrie numérique".

    [NDLR : la question comporte un deuxième volet complémentaire plus orienté souveraineté qu'économie : « Le 17 février 2015, une société de sécurité informatique de renommée mondiale, Kaspersky, avançait que la NSA aurait placé un malware sur les disques durs des 12 plus gros constructeurs mondiaux. Cela ne faisait que confirmer les révélations d'Edward Snowden qui nous apprenaient en 2014 que la NSA plaçait des logiciels espions sur les composants réseaux d'équipementiers, notamment CISCO. » ]

    [...]

    Dans sa deuxième question, Laure de la Raudière dénonce l'importance donnée à Cisco pour la formation des professionnels ou des étudiants. "C'est un investissement rentable pour les grands constructeurs et éditeurs qui fidélisent ainsi les futurs décideurs à leurs produits", assure-t-elle, en demandant "communication des raisons pour lesquelles le Premier ministre a souhaité confier ce programme de formation à une entreprise américaine plutôt que par exemple à des partenaires français tels que l'Ecole 42, OVH, Atos, Orange, Cap Gemini... en capitalisant sur nos laboratoires publics (CNRS, INRIA... )".

    [NDLR : je me demande si l'on a besoin de bourrer le crâne des étudiants avec n'importe quel produit de n'importe quelle entreprise, qu'elle soit française, européenne ou étrangère. Quelle que soit l'entreprise, celle-ci enseigne uniquement ses pratiques, sa manière de faire. Quid de la morale et des conflits d'intérêt (Orange apprendrait l'absence de neutralité des réseaux ? Bull apprendrait que le bien c'est de vendre des technos d'interception massive à des dictatures reconnues ? ... ) ? On enferme les étudiants dans un modèle de pensée unique. Exemple avec Cisco et ses certifs : on pense Cisco, c'est-à-dire qu'on ne pense pas la méthode logique sous-jacente, sous sa forme fondamentale mais à travers le prisme Cisco (pour faire ça, je tape telle commande sans vraiment comprendre les concepts sous-jacents). Ça sera pareil avec n'importe quelle entreprise. ]

    [...]

    Enfin, dans sa dernière question, la députée UMP demande au Gouvernement s'il a demandé son avis à l'Agence nationale de sécurité des systèmes d'information (ANSSI) avant de s'engager dans un tel partenariat avec un équipementier américain, et le cas échéant, de fournir cet avis au Parlement.  »
    March 5, 2015 at 11:28:11 AM UTC - permalink - http://www.numerama.com/magazine/32369-l-accord-entre-cisco-et-la-france-fustige-par-laure-de-la-raudiere-ump.html
  • Blog Stéphane Bortzmeyer: RFC 7454: BGP operations and security
    « Ce nouveau RFC résume l'état actuel des bonnes pratiques en matière de sécurité BGP. Du classique, aucune révélation, juste la compilation de l'état de l'art. Ce RFC porte aussi bien sur la protection du routeur, que sur le filtrage de l'information (les routes) reçues et transmises. [...] Ce genre de compilation aurait plutôt due être faite dans le cadre du project BCOP mais celui-ci semble mort.

    [...]

    La section 2 de ce RFC rappelle qu'il n'a pas de caractère obligatoire : il expose des pratiques de sécurité générales, et il est toujours permis de faire des exceptions, en fonction des caractéristiques spécifiques du réseau qu'on gère.

    Donc, au début (sections 4 et 5 du RFC), la protection de la discussion entre deux routeurs, deux pairs BGP qui communiquent (sécurité du canal). Ensuite (sections 6 à 11), la protection des informations de routage échangées, le contrôle de ce qui est distribué (sécurité des données).

    Commençons par sécuriser le routeur (section 4). Il devrait idéalement être protégé par des ACL qui interdisent les connexions vers le port 179, celui de BGP, sauf depuis les pairs connus. Les protections de TCP ne suffisent pas forcément, la mise en œuvre de TCP dans les routeurs est parfois faite de telle façon qu'on peut planter le routeur juste en envoyant plein de demandes de connexion. Il faut donc les jeter avant même que TCP ne les voit.

    [...]

    Certains routeurs permettent également de mettre en place un limiteur de trafic, pour éviter du trafic excessif, même en provenance de pairs connus.

    [...]

    Ensuite (section 5 du RFC), la protection des sessions BGP avec les pairs légitimes (cf. RFC 6952). Si les deux routeurs ne prennent aucune précaution, un attaquant pourrait, par exemple, couper leur session BGP en envoyant de faux paquets TCP de type RST (cf. RFC 5961). Pire, il pourrait, avec des techniques comme l'usurpation ARP, injecter de faux paquets dans une session BGP existante. Pour se protéger contre les attaques TCP, il faut utiliser une authentification TCP, comme la traditionnelle (et bien dépassée) TCP-MD5 du RFC 2385. [...] En outre, MD5 étant désormais bien affaibli (RFC 6151), il faudrait désormais utiliser le mécanisme AO du RFC 5925. Le RFC note que, malgré le caractère antédiluvien de TCP-MD5, c'est toujours la solution la plus utilisée par les opérateurs.

    [...]

    Autre précaution, filtrer les paquets IP en entrée du réseau de l'opérateur pour interdire les paquets prétendant avoir une adresse IP source située dans le réseau de l'opérateur. Sans cette précaution, même les sessions iBGP pourraient être attaquées.

    [...]

    Dernière protection des sessions BGP, GTSM (RFC 5082) qui consiste à tester que le TTL des paquets entrants est à la valeur maximale (255), et que le paquet vient donc bien du réseau local (s'il était passé par, ne serait-ce qu'un seul routeur, le TTL aurait été décrémenté).

    [...]

    Sécuriser la session ne sert à rien si le pair légitime et authentifié nous envoie des informations fausses. La section 6 de notre RFC se consacre donc au filtrage des préfixes annoncés. D'abord, les préfixes non routables (ceux marqués Global: false dans le registre des adresses spéciales IPv4 ou son équivalent IPv6) devraient évidemment être rejetés. Mais il est également recommandé de ne pas accepter les préfixes non alloués (par le système d'allocation d'adresses IP IANA->RIR->LIR). Comme la liste de ces préfixes change tout le temps, les filtres doivent être mis à jour automatiquement, à partir de la liste à l'IANA.

    [...]

    Tester auprès de l'IANA ne permet que des filtres grossiers, éliminant les annonces de préfixes non alloués à un RIR, ce qui ne sert que pour IPv6, ne vérifie pas les préfixes plus spécifiques que ce que l'IANA alloue, et n'empêche pas un malveillant ou un maladroit d'annoncer les préfixes d'un autre AS. Il peut donc être intéressant de filtrer de manière plus précise, en regardant les IRR. [...] Des outils existent pour produire automatiquement des filtres sur le routeur à partir du RPSL (comme IRRToolSet). Malheureusement, aucun IRR n'est parfait (et certains sont vraiment imparfaits) : préfixes absents (surtout les plus spécifiques, en cas de dés-agrégation des annonces), information dépassée, etc. Les IRR des RIR sont proches des opérateurs et donc a priori ont une information fiable mais ce n'est que théorique (les préfixes IP « du marais », alloués avant l'existence des RIR, sont une source particulièrement importante de problèmes). En outre, l'IRR d'un RIR ne couvre que la région de ce RIR, et on peut donc avoir besoin d'en consulter plusieurs (on a un pair états-unien, on regarde la base de l'ARIN, mais ce pair a des clients sud-américains et on doit donc aussi regarder la base de LACNIC...), ce qui justifie les IRR privés, comme RADB, qui essaient de consolider l'information des RIR.

    [...]

    Dans le futur, il est possible qu'un système plus fiable soit adopté et déployé, le couple RPKI+ROA, alias SIDR pour Secure Inter-Domain Routing. SIDR repose sur une infrastructure de certification, la RPKI (RFC 6480), et sur des objets signés, les ROA (RFC 6482), annonçant quel AS peut annoncer tel préfixe.

    [...]

    D'autres filtrages sont possibles en entrée. Par exemple, les opérateurs filtrent les annonces trop spécifiques, afin notamment d'éviter la croissance indéfinie de leurs bases de données et tables de routage. Chacun choisit les valeurs quantitatives précises et il n'y a pas de consensus documenté sur ce point (on peut consulter les documents RIPE-399 et RIPE-532) mais on peut observer qu'un préfixe plus long que /24 en IPv4 et /48 en IPv6 a très peu de chances d'être accepté dans l'Internet.

    Typiquement, on filtre aussi en entrée les annonces portant sur les préfixes internes. Normalement, ce n'est pas à nos voisins d'annoncer nos routes ! Autres préfixes souvent filtrés, les routes par défaut, 0.0.0.0/0 en IPv4 et ::0/0 en IPv6. Naturellement, les recommandations de filtrage dépendent du type d'appairage BGP : on ne filtre pas pareil selon qu'on parle à un pair, à un client ou à un transitaire (voir la section 6 du RFC pour tous les détails). Ainsi, pour reprendre le paragraphe précédent, sur la route par défaut, certains clients d'un opérateur demandent à recevoir une telle route et c'est tout à fait acceptable.

    [...]

    La section 7 est consacrée à une pratique très utilisée et très discutée, l'amortissement (damping). Lorsqu'une route vers un préfixe IP donné passe son temps à être annoncée et retirée, on finit par l'ignorer, pour éviter que le routeur ne passe son temps à recalculer ses bases de données. Pour réaliser cela, à chaque changement d'une route, on lui inflige une pénalité, et au bout d'un certain nombre de pénalités, on retire la route. Malheureusement, cette technique mène parfois à supprimer des routes et à couper un accès (voir RIPE-378). Avec de meilleurs paramètres numériques, comme recommandé par le RFC 7196 et RIPE-580, l'amortissement redevient utilisable et recommandable.

    [...]

    Autre technique de filtrage des erreurs, décrite en section 8, l'imposition d'un nombre maximum de préfixes annoncés par un pair BGP. S'il en annonce davantage, on coupe la session BGP. Un dépassement du nombre maximal est en effet en général le résultat d'une fuite, où, suite à une erreur de configuration, le routeur ré-annonce des routes reçues d'un autre. Parfois, c'est toute la DFZ qui est ainsi annoncée par accident aux pairs ! Notre RFC demande donc instamment qu'on limite le nombre de préfixes accepté pour une session BGP. Pour un pair sur un point d'échange, le seuil devrait être inférieur au nombre de routes de la DFZ (dans les 530 000 en IPv4 aujourd'hui, et 21 000 en IPv6), pour détecter les annonces accidentelles de toute la DFZ. On peut aussi avoir des seuils par pair, fondés sur le nombre de routes qu'ils sont censés annoncer. Pour un transitaire, par contre, le seuil doit être plus élevé que le nombre de routes dans la DFZ, puisqu'on s'attend à tout recevoir d'eux (mais une valeur maximale est quand même utile en cas de désagrégation intensive). Comme l'Internet change tout le temps, il faut réviser ces limites, et suivre les alertes [...]

    Voyons d'abord le filtrage par chemin d'AS. Par exemple, un client d'un opérateur ne devrait pas annoncer des routes avec n'importe quels AS mais seulement avec un chemin comportant uniquement son propre AS (et, si le client a lui-même des clients, avec l'AS de ces clients secondaires). Si l'opérateur n'arrive pas à avoir une liste complète des AS qui peuvent se retrouver dans les chemins de ses clients, au moins peut-il limiter la longueur de ces chemins, pour éviter la ré-annonce accidentelle de routes. D'autre part, on n'accepte pas, dans le cas normal, de routes où un AS privé (64512 à 65534 et 4200000000 à 4294967294, voir RFC 6996) apparait dans le chemin. Conséquence logique, on n'annonce pas à ses voisins de routes avec des chemins d'AS qui incluent un AS privé, sauf arrangement spécifique. Et le chemin d'AS dans une annonce BGP doit toujours commencer par l'AS du voisin (sauf si on parle à un serveur de routes).

    [...]

    Quant au filtrage sur le routeur suivant (section 10 du RFC), il consiste à refuser une route si l'attribut BGP NEXT_HOP (RFC 4271, section 5.1.3) n'est pas l'adresse du voisin. Attention, ce test doit être débrayé si on parle à un serveur de routes, celui-ci ne souhaitant pas traiter les paquets IP. Idem (débrayage du test) si on fait du RTBH (RFC 6666). »
    March 5, 2015 at 11:09:49 AM UTC - permalink - https://www.bortzmeyer.org/7454.html
  • Signal » Blog Archive » Petite histoire de la neutralité d’Internet à travers les âges
    « Donc nous sommes en 2015, où après 4 échecs sanglants du modèle telco des vrais spécialistes, les vrais spécialistes reviennent nous expliquer que la neutralité d’Internet, ce n’est pas bien sérieux et ça va empêcher le réseau de se développer pour faire des vraies choses dont nous allons avoir besoin très bientôt.

    Alors… vous les croyez encore, vous ? »

    Via http://shaarli.cafai.fr/?D9LD_Q
    March 4, 2015 at 6:11:31 PM UTC - permalink - http://signal.eu.org/blog/2015/02/28/petite-histoire-de-la-neutralite-dinternet-a-travers-les-ages/
  • Secret des affaires : agissons pour la protection des lanceurs d'alerte ! | La Quadrature du Net
    « Fin avril 2015, la directive « secret des affaires » sera débattue au Parlement européen. Après avoir cédé à la pression des journalistes pour retirer l'article correspondant de la loi Macron, La Quadrature du Net, Pila, et de nombreuses autres organisations appellent le président François Hollande et les élus européens à défendre les lanceurs d'alerte, à définir et protéger leur statut, et à assurer les moyens nécessaires à un réel suivi judiciaire des crimes et délits révélés. La situation souvent dramatique des lanceurs d'alertes, tels Edward Snowden ou Chelsea Manning, doit être protégée et sécurisée pour la sauvegarde des libertés fondamentales.

    Le 30 janvier dernier, devant la forte mobilisation des journalistes français, François Hollande demandait le retrait de l'article sur le secret des affaires de la loi Macron. Malgré cette victoire pour la liberté d'informer et de dénoncer les agissements illégaux de sociétés privées, les lanceurs d'alerte restent menacés. En effet, une directive européenne sera débattue fin avril au Parlement européen, dont le texte actuel criminalise l'atteinte au secret des affaires en Europe, sans protection effective des lanceurs d'alertes. Afin d'alerter sur les dangers pesant sur la liberté d'informer, La Quadrature du Net cosigne aujourd'hui une tribune dans Libération et une lettre ouverte envoyée au Président de la République française.

    [...]

    « Grâce aux révélations d'Edward Snowden sur la surveillance des communications, à celles de Swissleaks sur l'abus du secret bancaire, ou encore de Luxleaks sur les arrangements des grandes sociétés avec l'impôt en Europe, l'Union européenne découvre l'importance des lanceurs d'alerte et de la possibilité de dénoncer les crimes, délits et absences de limites morales des sociétés privées et structures publiques. Il est inadmissible que ces mêmes lanceurs d'alertes soient menacés de sanctions par les membres du Parlement européen au nom de la protection d'intérêts privés ! Au contraire, il est urgent de contribuer à leur protection et d'enfin mettre en place de réelles procédures d'investigation une fois ces crimes et délits révélés au public » s'indigne Benjamin Sonntag, co-fondateur de La Quadrature du Net. »
    March 3, 2015 at 6:38:18 PM UTC - permalink - http://www.laquadrature.net/fr/secret-des-affaires-agissons-pour-la-protection-des-lanceurs-dalerte
  • Facebook n'a pas besoin de votre mot de passe pour accéder à votre compte | Slate.fr
    Ce truc qui commence à circuler partout est du grand n'importe quoi, il faut remettre les pendules à l'heure d'urgence.

    1) Oui, les admins de Facebook ont accès à TOUTES les données stockées sur une machine dont le proprio est Facebook. Sans blague ! Il n'y a pas de données privées pour un root (exception faite du chiffrement dont vous contrôlez totalement la clé et encore, c'est pour un laps de temps donné inconnu à l'avance (car ça dépend des avancées cryptanalyse/mathématiques)). En informatique, le root (l'admin) d'une machine a accès à TOUTES les données de la machine. TOUTES. L'admin qui travaille chez un gros hébergeur a accès à TOUTES les données stockées sur TOUTES les machines qui font partie de son périmètre d'intervention au mieux, à TOUTES les données stockées sur TOUTES les machines de la société au pire. Le root d'un réseau (FAI, opérateur) peut avoir accès à TOUTES les données qui circulent sur son réseau. Tout cela à votre insu, sans avoir à vous demander une quelconque autorisation et sans laisser de traces de votre côté (il peut y avoir des logs de leur côté). C'est une ÉVIDENCE. Oui, le POUVOIR des ADMINS est ÉNORME.

    2) Si vous n'acceptez pas ce fait : auto-hébergement ou hébergement dans une asso de confiance (les admins auront toujours accès à toutes vos données mais vous les avez choisis, vous les connaissez), ne pas mettre des choses privées (que vous ne voulez pas voir divulger un jour) dans les sections dites "privées" de grosses plateformes centralisées ou alors utiliser une méthode de chiffrement dont vous seul avez la clé !

    Plutôt que d'apprendre aux jeunes à coder à l'école, il faudrait déjà leur apprendre les bases : comment fonctionne un ordinateur, un réseau et Internet.

    Via https://twitter.com/bortzmeyer/status/572795465030213633
    March 3, 2015 at 6:00:53 PM UTC - permalink - http://www.slate.fr/story/98537/facebook-mot-de-passe-acces-compte
  • Michel Combes : « Le patriotisme économique n’est pas un gros mot », High tech
    Il faut lire cette entrevue avec le directeur général d'Alcatel-Lucent car c'est magique : du bullshit (digitalisation/digitale, tsunami de data, éco-efficacité des réseaux,...), de l'auto-promo (« Encore faut-il en avoir la capacité. A l’avenir, il n’y aura pas de souveraineté possible sans une maîtrise certaine des couches applicatives et technologiques. » / « Aujourd’hui, 10 % à 15 % des brevets qu’Alcatel-Lucent dépose portent sur l’éco-efficacité des réseaux. »), des propos pour nous endormir et des propos inquiétants...

    Propos pour endormir le bon couillon :
    « Avec la fibre, on a comme agrandi les voies. Mais cela ne suffit plus. C’est maintenant l’architecture même des réseaux qu’il faut revoir. Il va falloir les remplacer par des architectures distribuées, beaucoup moins centralisées, permettant d’amener les infrastructures à haut débit au plus près des clients finaux. Ce qui suppose d’installer un peu partout d’énormes data centers, avec à la clé des nouvelles problématiques de sécurité. »
    => Il a tout compris à l'acentricité du réseau et à la production locale et autonorme d'électricité, lui. :)

    « Des problèmes de résilience, d’abord. Il faut être d’autant plus en mesure d’éviter la panne que l’ensemble de l’économie devient numérique, et donc passe par les réseaux, de la gestion des feux tricolores dans les rues jusqu’aux capteurs dans le domaine de la santé, par exemple. Or il reste des points de vulnérabilité, comme l’ont récemment montré les pannes de bases de données de réseaux mobiles, qu’il faudra à l’avenir décentraliser. »

    Les propos inquiétants :
    « Se posent, ensuite, des problèmes de cybersécurité. Il faut repérer les points de vulnérabilité et regarder quels équipements doivent être installés sur les réseaux pour en renforcer la sécurité. La problématique est que 50 % du trafic qui circule sur les réseaux des opérateurs est crypté. Il ne serait pas illogique de permettre aux pouvoirs publics de savoir ce qui se passe sur les réseaux, dans un cadre juridique approprié, ce qui suppose de mettre en place des outils grâce auxquels les opérateurs pourront accéder aux informations transitant par leurs infrastructures. »
    => crypté = L-O-L ; cadre juridique approprié = mais bien sûr, endors-nous ! Tu les sens mes middleboxes DPI et mon MITM actif ? No way !
    March 2, 2015 at 11:00:21 AM UTC - permalink - http://www.lesechos.fr/tech-medias/hightech/0204190139261-michel-combes-michel-combes-le-patriotisme-economique-nest-pas-un-gros-mot-1097709.php
  • ssh - How do I get the RSA bit length with the pubkey and openssl? - Information Security Stack Exchange
    Obtenir la taille d'une paire de clé SSH et son fingerprint : ssh-keygen -lf /chemin/vers/la/partie/publique (exemple  /etc/ssh/ssh_host_rsa_key.pub )
    March 1, 2015 at 3:25:17 PM UTC - permalink - https://security.stackexchange.com/questions/42268/how-do-i-get-the-rsa-bit-length-with-the-pubkey-and-openssl
  • Du NATv4 sous Linux
    Un petit résumé des différents modes de NAT IPv4 possibles sous Linux avec les commandes iptables kivontbien pour les mettre en pratique.

    NAT 1:1 pour une seule IP (on veut mapper une seule adresse IP privée sur une seule adresse IP publique) :
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_ip> -j SNAT --to-source <public_ip>

        Pour pouvoir initier des connexions depuis l'extérieur (usage serveur, par exemple) :
        iptables -t nat -A PREROUTING -i <public_interface> -d <public_ip> -j DNAT --to-destination <private_ip>


    NAT 1:1 pour un réseau entier (on veut mapper une plage d'adresses IP privées sur une plage d'adresses IP publiques. Il faut donc autant d'IP publiques que d'IP privées. ) :
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -j NETMAP --to <public_subnet>

        Pour pouvoir initier des connexions depuis l'extérieur :
        iptables -t nat -A PREROUTING -i <public_interface> -d <public_subnet> -j NETMAP --to <private_subnet>

        Le numéro de machine est conservé, seule la partie réseau est réécrite. Exemple : 198.18.0.1/24 deviendra 198.18.1.1/24. 198.18.0.42/24 deviendra 198.18.1.42/24.
        Source : https://capcorne.wordpress.com/2009/03/24/natting-a-network-range-with-netmapiptables/


    NAPT (on veut mapper plusieurs IP privées sur une seule IP publique statique/invariante/connue) :
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -j SNAT --to-source <public_range (exemple : 192.0.2.1-192.0.2.4,192.0.2.10)>

        Évidemment, il est possible d'avoir un seul couple IP_publique/protocole de transport(UDP/TCP/SCTP)/port associé à un couple IP_privée/protocole de transport/port en utilisant la cible DNAT (voir ci-dessus). Redirection de port/ouverture de port habituelle.


    NAPT dynamiquee (on veut mapper plusieurs IP privées sur une seule IP publique obtenue dynamiquement et pouvant varier dans le temps (ex. : DHCP)) :
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -j MASQUERADE

        Évidemment, il est possible d'avoir un couple IP_publique/protocole de transport(UDP/TCP/SCTP)/port associé à un couple IP_privée/protocole de transport/port en utilisant la cible DNAT (voir ci-dessus). Redirection de port/ouverture de port habituelle.


    NAPT  (on veut mapper plusieurs IP privées sur plusieurs IP publiques mais on n'a pas le même nombre d'IP privées que de publiques) :
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -j SNAT --to-source <public_range (exemple 192.0.>
        => Cette méthode a disparue depuis Linux v2.6.11 - http://lists.netfilter.org/pipermail/netfilter-devel/2004-November/017468.html

        OU

        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -j SAME --to <public_range (exemple : 192.0.2.1-192.0.2.4,192.0.2.10)>
        => Le man nous indique « N.B.: The DNAT target's --persistent option replaced the SAME target. » et la cible SAME n'est plus reconnue actuellement (testé avec un noyau 3.2 et noyau 3.16). L'option « persistent » de la cible DNAT ne convient pas à notre besoin.

        Source : http://serverfault.com/questions/647343/load-balancing-iptables-postrouting-rules

        OU

        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -m statistic --mode nth --every 2 --packet 0 -j SNAT --to-source <public_IP1>
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -j SNAT --to-source <public_IP2>

        Même exemple mais avec 4 IP publiques :
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -m statistic --mode nth --every 4 --packet 0 -j SNAT --to-source <public_IP1>
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -m statistic --mode nth --every 3 --packet 0 -j SNAT --to-source <public_IP2>
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -m statistic --mode nth --every 2 --packet 0 -j SNAT --to-source <public_IP3>
        iptables -t nat -A POSTROUTING -o <public_interface> -s <private_subnet> -j SNAT --to-source <public_IP4>
       
        Source : http://serverfault.com/questions/647343/load-balancing-iptables-postrouting-rules

        Ainsi, toutes les « -- every » connexions (dans l'exemple précédent : à chaque nouvelle connexion), l'IP de sortie change, round-robin style comme l'ancien comportement de la cible SNAT avec plusieurs IP. Évidemment, il n'y a pas d'associations entre IPs donc une même machine pourra sortir avec deux IP différentes à un même instant T dans deux applications différentes. Encore plus impressionnant : l'IP peut différer au sein d'une même application. Exemple typique : le chargement d'une page web moderne se décompose en : contenu principal sur serveur avec l'IP1, images sur CDN dont un des serveurs à l'IP2, font chez Google donc IP3, ajax chez Google donc IP4,... C'est tout autant de connexions différentes qui sont effectuées par le navigateur web et qui seront réparties sur plusieurs IP par la passerelle NAT.

    Cela complique les debug puisqu'un test sur un site externe de type "quelle est mon IP ?" ne reflétera pas l'IP source de toutes les connexions initiées depuis la machine. ;)

    Ce comportement ne semble pas perturber les sites web bien codés, même les plus nazis sur l'origine des connexions comme Google dans GMail. Par contre, attention aux sites web qui matchent l'IP source actuelle avec celle contenue dans un cookie pour vérifier que vous êtes bien autorisé à vous connecter à une partie sécurisée du site web et qui vous déconnectent le cas échéant. Pour éviter ce type de problème, on peut aussi écrire un script pour ajouter X règles iptables avec la cible SNAT et un filtre par source (« -s ») qui réparti les IP sources privées sur les IP publiques. Ainsi une même IP source privée aura toujours la même IP source publique. On peut aussi segmenter le réseau interne en plusieurs sous-réseau. Chaque plage d'IP aura sa propre IP publique de sortie.

    Malgré ce que dit le man, le module « statistic » réparti bien les connexions, pas les paquets. Le contraire forcerait des retransmissions et donc latence voir perte si UDP + aucun mécanisme de récup' des erreurs au niveau applicatif. Une même connexion aura un état dans la table NAT et l'adresse IP de chacun des paquets qui la compose sera donc réécrit avec la même adresse IP ! Pour visualiser les états du suivi des connexions Netfilter, on peut utiliser l'outil userland « conntrack » : voir http://shaarli.guiguishow.info/?WI9cXg .


    Ci-dessus, je parle d'adresses IPv4 publiques mais les commandes et le principe de fonctionnement reste identiques s'il on n'a pas d'IPv4 publiques mais uniquement plusieurs plages d'IP privées.
    February 28, 2015 at 9:43:57 PM UTC - permalink - http://shaarli.guiguishow.info/?ve8q_Q
  • Quelques points de détails sur DNS
    Parfois, on me demande des détails précis sur DNS tout en me demandant la section du RFC kivabien pour argumenter. Cette fois-ci, je me mets ça de côté.

        * Un CNAME dans un domaine A peut pointer sur un label dans un domaine B. C'est l'un des buts de ce RRTYPE, tout comme DNAME pour un sous-arbre. Source : RFC 2181, section 10.1 - « The DNS CNAME ("canonical name") record exists to provide the canonical name associated with an alias name.  There may be only one such canonical name for any one alias. That name should generally be a name that exists elsewhere in the DNS, though there are some rare applications for aliases with the accompanying canonical name undefined in the DNS »

        * Oui, il n'est pas conseillé (mais pas interdit) de chaîner les CNAME. Source : RFC 1034, section 5.2.2 - « Multiple levels of aliases should be avoided due to their lack of efficiency, but should not be signalled as an error. Alias loops and aliases which point to non-existent names should be caught and an error condition passed back to the client. »

        * Il est interdit de mettre un alias comme valeur d'un enregistrement de type MX ou NS. Source : RFC 2181, section 10.3 - « The domain name used as the value of a NS resource record, or part of the value of a MX resource record must not be an alias.  Not only is the specification clear on this point, but using an alias in either of these positions neither works as well as might be hoped, nor well fulfills the ambition that may have led to this approach. »

        * Pareil pour le RRTYPE SRV. Source : RFC 2782, - « The domain name of the target host.  There MUST be one or more address records for this name, the name MUST NOT be an alias (in the sense of RFC 1034 or RFC 2181). »

        * Il faut au moins 2 serveurs qui font autorité par zone même si c'est pas « MUST » mais « require ». RFC 2182, section 4.3.5 - « The DNS specification and domain name registration rules require at least two servers for every zone.  That is, usually, the primary and one secondary. [...] It is recommended that three servers be provided for most organisation level zones, with at least one which must be well removed from the others. »

        * Un paquet DNS n'est pas limité à 512 octets sur UDP. C'est tout l'intérêt de edns(0) normalisé en  1999. Source : RFC 2671, section 2.3 - « DNS Messages are limited to 512 octets in size when sent over UDP. While the minimum maximum reassembly buffer size still allows a limit of 512 octets of UDP payload, most of the hosts now connected to the Internet are able to reassemble larger datagrams. Some mechanism must be created to allow requestors to advertise larger buffer sizes to responders. »
    February 28, 2015 at 2:55:29 AM UTC - permalink - http://shaarli.guiguishow.info/?D_KSww
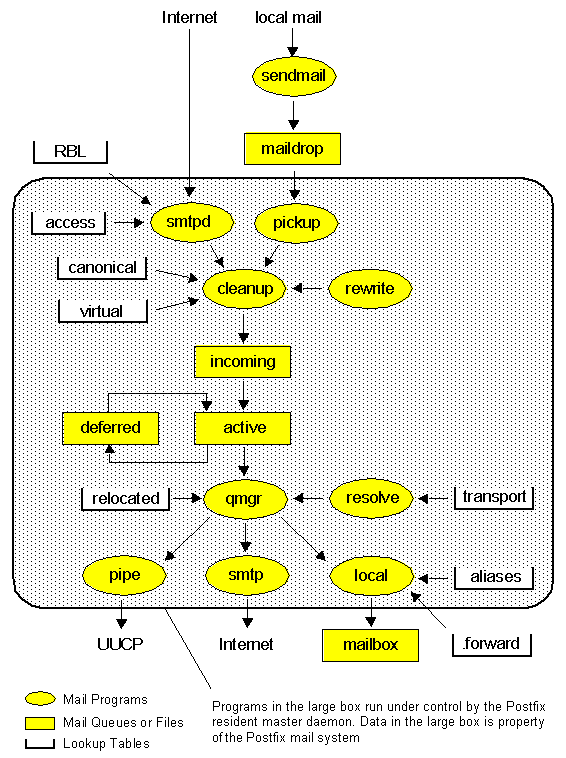
  • Postfix Architecture Diagram
    Un petit schéma avec les interactions entre les différents composants (modules) de Postfix et les différentes maps (aliases, transport, virtual, ...) utilisées à tel moment.
    February 27, 2015 at 8:13:13 PM UTC - permalink - http://www.akadia.com/img/postfix_architecture.gif
  • FCC votes for net neutrality, a ban on paid fast lanes, and Title II | Ars Technica
    Version courte : la victoire n'est pas totale (les services spécialisés ne sont pas morts dans la bataille) et n'est pas encore assurée (possible contournement par le congrès).


    « The Federal Communications Commission today voted to enforce net neutrality rules that prevent Internet providers—including cellular carriers—from blocking or throttling traffic or giving priority to Web services in exchange for payment.

    The most controversial part of the FCC's decision reclassifies fixed and mobile [NDLR : excellent point ! En France, c'est bien sur les accès mobiles que l'on voit le plus d'atteintes en ce moment] broadband as a telecommunications service, with providers to be regulated as common carriers under Title II of the Communications Act. This decision brings Internet service under the same type of regulatory regime faced by wireline telephone service and mobile voice, though the FCC is forbearing from stricter utility-style rules that it could also apply under Title II.

    [...]

    The vote was 3-2, with Democrats voting in favor and Republicans against.

    [...]

    The core net neutrality provisions are bans on blocking and throttling traffic, a ban on paid prioritization, and a requirement to disclose network management practices. Broadband providers will not be allowed to block or degrade access to legal content, applications, services, and non-harmful devices or favor some traffic over others in exchange for payment. There are exceptions for "reasonable network management" [NDLR : jusque là, c'est excellent quoi qu'il manque la non surveillance et la non altération des communications] and certain data services that don't use the "public Internet." Those include heart monitoring services and the Voice over Internet Protocol services offered by home Internet providers.

    [NDLR : donc la neutraltié des réseaux a été tronquée et les services spécialisés ont gagnés car ils n'ont pas été fermement encadrés (ils sont tolérables seulement si aucune autre offre équivalente techniquement ou en service rendu à l'utilisateur n'existe). Bah oui : des offres VOIP concurrentes, il y'en a d'autres (OVH en France, par exemple). Pourquoi uniquement celle de l'opérateur qui vous fournit l'accès au Net devrait être priorisée au détriment des autres ? Dailymotion est une filiale d'Orange. Le lien (administratif mais aussi au niveau interconnexion réseau) est donc direct entre Orange et Dailymotion, ça ne passe pas par Internet donc Orange pourrait prioriser Dailymotion au détriment de Youtube avec ce régime de régulation. Autrement dit, toute PNI (interconnexion privée entre deux opérateurs) pourra contourner cette régulation àmha.]

    The reasonable network management exception applies to blocking and throttling but not paid prioritization. [NDLR : excellent point]

    There are additional Title II requirements that go beyond previous net neutrality rules. There are provisions to investigate consumer complaints, privacy rules, and protections for people with disabilities. Content providers and network operators who connect to ISPs' networks can complain to the FCC about "unjust and unreasonable" interconnection rates and practices. There are also rules guaranteeing ISPs access to poles and other infrastructure controlled by utilities, potentially making it easier to enter new markets. [...]

    The FCC could have tried to use Title II to require last-mile unbundling, in which Internet providers would have to sell wholesale access to their networks. This would allow new competitors to enter local markets without having to build their own infrastructure. But the FCC decided not to impose unbundling. As such, the vote does little to boost Internet service competition in cities or towns. But it's an attempt to prevent incumbent ISPs from using their market dominance to harm online providers, including those who offer services that compete against the broadband providers' voice and video products. [NDLR : huuum, ça compense un peu les services spécialisés... à voir l'implémentation derrière...]

    [...]

    Today's order could face both legal challenges and action from Congress. Republicans have proposed legislation that would eliminate Title II restrictions for broadband providers and vowed that the FCC vote is just the beginning of the debate.

    Although many ISPs publicly oppose the new rules, the industry is by no means united against the FCC. Sprint and T-Mobile US have each said the FCC's proposal would not hurt their business. And while a good number of small broadband providers oppose the imposition of Title II rules, others support Wheeler. The NTCA Rural Broadband Association, which represents rural ISPs, said yesterday that it supports applying Title II to broadband networks.

    Sir Tim Berners-Lee, inventor of the World Wide Web, spoke to the commission via video. He credited the openness of the Internet with allowing him to create the Web 25 years ago without having to ask "permission."

    [...]The full net neutrality order has not been published yet. The FCC's majority is required to include the Republicans' dissents in the order and "be responsive to those dissents," Wheeler said. The order will go on the FCC's website after that process. The rules will go into effect 60 days after publication in the Federal Register, with one small exception. Enhancements to the transparency rule must undergo an additional review by the Office of Management and Budget because they make changes to the one part of the 2010 net neutrality order that survived court challenge. [NDLR : attendons donc la publication complète et les analyses qui suivront] »


    Un dernier point me laisse dubitatif : on est sur de la régulation télécoms semblable à ce que pourrait faire l'ARCEP si le contexte législatif derrière le lui permettrait. Pour moi (comme pour d'autres comme Benjamin Bayart), la neutralité des réseaux doit relever de la loi avec des sanctions pénales à la clé car le pouvoir des FAI sur le citoyen est monstrueux.


    L'avis de l'EFF (trop optimiste à l'heure actuelle, à mon goût) : https://www.eff.org/fr/deeplinks/2015/02/fcc-votes-net-neutrality-big-win
    « That’s great for making sure websites and services can reach ISP customers, but what about making sure customers can choose for themselves how to use their Internet connections without interference from their ISPs? To accomplish this, the FCC has banned ISPs from blocking or throttling their customers’ traffic based on content, applications or services—which means users, hackers, tinkerers, artists, and knowledge seekers can continue to innovate and experiment on the Internet, using any app or service they please, without having to get their ISP’s permission first.

    [...]

    But now we face the really hard part: making sure the FCC doesn’t abuse its authority.

    For example, the new rules include a “general conduct rule” that will let the FCC take action against ISP practices that don’t count as blocking, throttling, or paid prioritization. As we said last week and last year, vague rules are a problem. The FCC wants to be, in Chairman Wheeler’s words, “a referee on the field” who can stop any ISP action that it thinks “hurts consumers, competition, or innovation.” The problem with a rule this vague is that neither ISPs nor Internet users can know in advance what kinds of practices will run afoul of the rule. Only companies with significant legal staff and expertise may be able to use the rule effectively. And a vague rule gives the FCC an awful lot of discretion, potentially giving an unfair advantage to parties with insider influence. That means our work is not yet done.  We must stay vigilant, and call out FCC overreach. »

    J'attends l'avis de LQDN/FFDN sur le sujet.
    February 27, 2015 at 10:22:15 AM UTC - permalink - http://arstechnica.com/business/2015/02/fcc-votes-for-net-neutrality-a-ban-on-paid-fast-lanes-and-title-ii/
  • Secure Secure Shell
    Ça date mais j'attendais que ça se stabilise après les révélations d'Appelbaum et Poitras lors du 31C3 car la sécurité dans l'urgence est le moyen le plus sûr de faire n'importe quoi et d'obtenir un résultat pire que la situation que l'on cherche à améliorer/résoudre. À ce sujet, se reporter à la fin du billet linké par ce shaarli qui cause justement des mauvais choix initiaux faits en réaction zélée à la présentation d'Appelbaum et Poitras.


    Je pense que la crypto dans SSH est de la poudre aux yeux. Le débat RSA versus EC, par exemple, est un faux débat certes très intéressant pour les cryptographes (car ça permet les avancées) mais pas pour un adminsys. Les limites pratiques de la cryptographie surviennent sur des choses beaucoup plus connes et concrètes : générateur de nombres pseudos aléatoires pas assez aléatoires, bug logiciel, cryptographie mal utilisée (de la crypto avec IE6 sous XP, comment dire ...), ... Les deux procédés (EC et RSA) sont toujours d'actualité. Le seul argument de plus en faveur des courbes elliptiques est leur faible taille (à niveau de sécurité jugé équivalent) et des temps de traitement plus courts donc une meilleure montée en charge. Débat intéressant : la NSA recommande officiellement d'utiliser les courbes elliptiques plutôt que RSA, avec, dans le lot la courbe P-256 normalisée par le NIST. Partant de là : la NSA sait-elle casser RSA (et c'est donc pour cela qu'elle conseille aux sociétés/administrations US de passer à EC) ou EC-P256 (et c'est donc pour un espionnage massif qu'elle conseille d'y migrer) ? Pour se protéger de la NSA, faut-il suivre les conseils de la NSA ou aller à l'encontre ? :)


    Typiquement, avec SSH, la sécurité repose sur d'autres paramètres, notamment :
        * Désactiver SSHv1 ;

        * Authentification des clients par clé ou, à défaut, par mot de passe avec, dans ce cas-là, un anti-bruteforce ;

        * Désactiver la possibilité pour root de se connecter à distance (compte classique + su : double sécurité), utiliser la directive de configuration « Users » (qui permet d'indiquer quels utilisateurs du système sont autorisés à se connecter à distance) ;

        * Vérifier la fingerprint de la clé du serveur lors de la première connexion ! Ne pas mettre "yes" aveuglement ! Les fois suivantes, ne pas ignorer les messages d'erreur de SSH ! Et dans un futur proche, utiliser DNSSEC + SSHFP (http://shaarli.guiguishow.info/?X1OYWg)

        * UseDNS à no car en cas d'attaque volumétrique ((D)DoS), une requête DNS est effectuée à chaque connexion pour écrire dans auth.log : le déni de service est aggravé.


    Une autre ressource intéressante pondue par Aeris : https://pad.lqdn.fr/p/ssh-hardening
    « Ciphers :
        * RC4 est notoirement troué, donc à supprimer --> voir à ce propos le changelog http://www.openssh.com/txt/release-6.7

        * CBC n’a pas d’avantage comparé à GCM ou CTR, à supprimer source ? GCM n’est pas breveté, et GCM/CTR supportent la parallélisation

        * Blowfish n’est pas recommandé à l’usage par Bruce Schneier (son concepteur) lui-même source ? ? https://www.computerworld.com.au/article/46254/bruce_almighty_schneier_preaches_security_linux_faithful/?pp=3

        * Privilégie les méthodes non AES (chacha-poly)

        * Trie des AES dans l’ordre de taille de clef

        * Préférence pour GCM, puis CTR

        * CAST128 est breveté


    HostKey :
        * Pas d’utilité des suites -cert (pas utilisé ?)

        * Privilégie les méthodes ECC sur RSA/DSA

        * Privilégie les méthodes non NIST (ED) sur celles NIST (ECDSA)


    Kex :
        * Suppression des suites SHA-1 (trop faible)

        * Privilégier les ECC sur les DH

        * Privilégie les méthodes non NIST (CURVE) sur celles NIST (ECDH)


    MACs :
        * Suppression SHA-1 et MD-5 (trop faible)

        * Suppression des algos < 128 bits (64 & 96)

        * Trie dans l’ordre des tailles de hash (512, 256 puis 128)

        * Privilégier les -ETM (encrypt then mac)

        * Privilégier RIPEMD sur SHA-2 ?

        * Quid sécu UMAC comparée à HMAC / SHA-2 / RIPyMEND ? »


    Ce qui suit se place dans un contexte d'auto-hébergement : je suis le (quasi) seul utilisateur de mes machines, je n'ai pas de clients/adhérents/autres. Dans le cas contraire, il faut être très prudent dans les algorithmes que l'on désactive car on exclu souvent des logiciels clients. Exemple : PuTTY ne supporte pas hmac-sha512, WinSCP ne supporte pas curve25519-sha256, la version d'OpenSSH sur FreeBSD ne supporte pas hmac-sha512, ...


    Et rappelez-vous : je ne suis pas une bête en crypto, hein. ;)


    L'union des deux ressources précédentes donne ça :
    ---- HostKeyAlgorithms (côté client !)
    1) On vire les algos « -cert » car inutilisés, on ajoute « ssh-ed25519 » (algo récent, courbes elliptiques, hors NIST) :
        ssh-ed25519,ecdsa-sha2-nistp521,ecdsa-sha2-nistp384,ecdsa-sha2-nistp256,ssh-rsa

    2) Plus nazi : on vire ssh-dss. Puis on vire les ecdsa possiblement owned par NIST/NSA
        ssh-ed25519,ssh-rsa

    Ça donne ça :
        Pour Debian Jessie :
            Host *
                HostKeyAlgorithms ssh-ed25519,ssh-rsa

        Pour Debian Wheezy (ssh-ed25519 n'est pas présent dans la version 6.0 d'OpenSSH)
            Host *
                HostKeyAlgorithms ssh-rsa

    3) On continue côté serveur :
    Sous Wheezy, dans /etc/sshd_config, il doit rester une seule ligne :
        HostKey /etc/ssh/ssh_host_rsa_key

    Pour Jessie :
        HostKey /etc/ssh/ssh_host_ed25519_key
        HostKey /etc/ssh/ssh_host_rsa_key

    4) On peut aussi en profiter pour régénérer des clés robustes (attention donc à vos clients qui vous informerons, à raison, que la fingerprint de votre serveur a changé).
    cd /etc/ssh
    rm ssh_host_*key*
    ssh-keygen -t rsa -b 4096 -f ssh_host_rsa_key

    Sous Jessie on peut ajouter :
    ssh-keygen -t ed25519 -f ssh_host_ed25519_key


    ---- KexAlgorithms
    1) On vire les algos avec sha1 (car avancées cryptos, un des prochains algos qui tomberont, prendre de l'avance,...) :
        curve25519-sha256@libssh.org,ecdh-sha2-nistp256,ecdh-sha2-nistp384,ecdh-sha2-nistp521,diffie-hellman-group-exchange-sha256

    2) Plus nazi : on vire les ecdh possiblement owned par NIST/NSA
        curve25519-sha256@libssh.org,diffie-hellman-group-exchange-sha256

    Ça donne ça :
        Pour Debian Jessie :
            KexAlgorithms curve25519-sha256@libssh.org,diffie-hellman-group-exchange-sha256

        Pour Debian Wheezy (curve25519-sha256@libssh.org n'est pas présent dans la version 6.0 d'OpenSSH)
            KexAlgorithms diffie-hellman-group-exchange-sha256


    awk '$5 > 2000' /etc/ssh/moduli > "${HOME}/moduli"
    wc -l "${HOME}/moduli" # make sure there is something left
    mv "${HOME}/moduli" /etc/ssh/moduli


    ---- Ciphers
    1) On vire tous les ciphers faibles (arcfour (petit nom de RC4), 3DES) ou couverts par un brevet (cast128).
        chacha20-poly1305@openssh.com,aes256-gcm@openssh.com,aes128-gcm@openssh.com,aes256-ctr,aes192-ctr,aes128-ctr

    2) Nazi par GuiGui : virer les algos 128/192 bits puisque 256 bits disponibles
        chacha20-poly1305@openssh.com,aes256-gcm@openssh.com,aes256-ctr

    Ça donne ça :
        Pour Debian Jessie :
            Ciphers chacha20-poly1305@openssh.com,aes256-gcm@openssh.com,aes256-ctr

        Pour Debian Wheezy (chacha20-poly1305 et GCM ne sont pas implémentés dans la version 6.0 d'openSSH)
            Ciphers aes256-ctr


    ---- MACs
    1) On vire les fonctions de hachage faibles/cassées (MD5, SHA1)
        MACs hmac-sha2-512-etm@openssh.com,hmac-sha2-256-etm@openssh.com,hmac-ripemd160-etm@openssh.com,umac-128-etm@openssh.com,hmac-sha2-512,hmac-sha2-256,hmac-ripemd160,umac-128@openssh.com

    2) Pour moi encrypt-then-MAC (http://www.bortzmeyer.org/7366.html) passe après l'utilisation de bons algos, je fais + confiance aux fonctions de la famille sha2 (même si normalisées au NIST, l'important est leur robustesse démontrée par l'usage et surtout, la variété : utiliser des algos pas normalisés par le NIST en complément d'algos normalisés par le NIST), enfin, ripemd160 arrive en dernier
        Macs hmac-sha2-512-etm@openssh.com,hmac-sha2-256-etm@openssh.com,hmac-sha2-512,hmac-sha2-256,hmac-ripemd160-etm@openssh.com,umac-128@openssh.com,hmac-ripemd160

    3) Encore plus nazi : on vire umac-128 (que je ne connais pas), ripemd160 (car seulement 160 bits comme sha1), et on vire sha256 puisque sha512 est disponible
        MACs hmac-sha2-512-etm@openssh.com,hmac-sha2-512

    Ça donne ça :
        Pour Debian Jessie :
            MACs hmac-sha2-512-etm@openssh.com,hmac-sha2-512

        Pour Debian Wheezy (encrypt-then-MAC n'est pas disponible dans OpenSSH 6.0):
            MACs hmac-sha2-512


    On peut aussi blinder la conf' côté client et mettre les directives de configurations suivantes :
        Pour Debian Jessie :
            Host *
                HostKeyAlgorithms ssh-ed25519,ssh-rsa
                KexAlgorithms curve25519-sha256@libssh.org,diffie-hellman-group-exchange-sha256
                Ciphers chacha20-poly1305@openssh.com,aes256-gcm@openssh.com,aes256-ctr
                MACs hmac-sha2-512-etm@openssh.com,hmac-sha2-512

        Pour Debian Wheezy :
            Host *
                HostKeyAlgorithms ssh-rsa
                KexAlgorithms diffie-hellman-group-exchange-sha256
                Ciphers aes256-ctr
                MACs hmac-sha2-512

    Mais attention si vous vous connectez sur différents équipements qui n'ont pas le support de ces algorithmes (routeurs/switchs, appliances, ...) car le debug est un peu chiant pour identifier la cause.
    February 27, 2015 at 2:10:42 AM UTC - permalink - https://stribika.github.io/2015/01/04/secure-secure-shell.html
  • Generate an OpenSSL Certificate Request with SHA256 Signature | IT Igloo
    Il suffit de rajouter l'option « -sha256 » lors de la génération de la CSR. Pareil lors de la génération du certificat à partir de la CSR dans le cas d'un cert auto-signé ou d'une AC personnelle.
    February 26, 2015 at 11:38:00 PM UTC - permalink - http://itigloo.com/security/generate-an-openssl-certificate-request-with-sha-256-signature/
  • Stéphane Bortzmeyer sur Twitter : "Un petit pas pour M. Michu, un grand pas pour la sécurité du #DNS : le résolveur sur les Freebox valide désormais avec #DNSSEC."
    « Un petit pas pour M. Michu, un grand pas pour la sécurité du #DNS : le résolveur sur les Freebox valide désormais avec #DNSSEC.
    Et avec DLV, ce qui est une idée contestable. »

    On enchaîne avec quelques rappels de base :
    « Tous les domaines avec une config #DNSSEC incorrecte vont donc être inaccessibles depuis Free.
    Un résolveur validant peut être menteur. Voilà pourquoi l'idéal est de valider sur sa machine. »

    On commence déjà à voir ce que je décrivais ici http://www.guiguishow.info/2012/08/21/domain-name-system-attaques-et-securisation/#toc-2827-limites (deuxième paragraphe) : quand on met en place un serveur DNS récursif validant, les utilisateurs de ce récursif et, si votre récursif sert un nombre significatifs d'utilisateurs, les gestionnaires techniques de domaines invalides (d'un point de vue DNSSEC) vous font endosser une responsabilité qui n'est pas la vôtre en vous hurlant dessus quand ça ne marche pas... Même quand l'erreur est de leur côté. Premier exemple (DS dans la zone parente mais pas de DNSKEY dans la zone fille) :
    « Maëva ‏@lechat_et_moi :
    @freemobile @LALIGNEDEFREE comment on fait quand nos lecteurs du blog qui ont Free be peuvent pas accéder au blog depuis 2 mois?

    avicom ‏@agence_avicom :
    @lechat_et_moi @LALIGNEDEFREE nous sommes les hébergeurs, et ça ne vient pas de chez nous ! Aucun IP de Free n'accède au site.

    Free ‏@LALIGNEDEFREE :
    @agence_avicom @lechat_et_moi un traceroute.?

    Mathieu ‏@oustedaisse :
    @agence_avicom @lechat_et_moi @LALIGNEDEFREE en même temps, vu que la conf DNSSEC du domaine est pétée, c'est normal que ça marche pas...

    Mathieu ‏@oustedaisse :
    @agence_avicom @lechat_et_moi @LALIGNEDEFREE en haut avec DNSSEC actif en bas DNSSEC désactivé. Le pb est chez vous;) pic.twitter.com/ARhQrNasYb

    avicom ‏@agence_avicom :
    @lechat_et_moi @LALIGNEDEFREE On va regarder ça ! Merci @oustedaisse de votre aide on vous tient au courant ;)

    avicom ‏@agence_avicom :
    @oustedaisse @lechat_et_moi @LALIGNEDEFREE ça ne vient pas de là ! Même free n'utilise pas encore cette norme... En tout cas merci !

    Mathieu ‏@oustedaisse :
    @agence_avicom @lechat_et_moi @LALIGNEDEFREE Ha si, ça vient de là pourtant, regardez bien... Le même pb avec Google DNS également.

    avicom ‏@agence_avicom :
    @oustedaisse @lechat_et_moi @LALIGNEDEFREE DNSSEC est une nouvelle norme pour parler aux serveurs DNS de manière chiffrée comme DKIM
    [ NDLR : KAMOULOX ! Il n'y a rien d'exact dans ce tweet ! O_O ]

    Mathieu ‏@oustedaisse :
    @agence_avicom @lechat_et_moi @LALIGNEDEFREE dites... Je suis au courant merci.

    avicom ‏@agence_avicom :
    @oustedaisse @lechat_et_moi @LALIGNEDEFREE donc c'est une norme donc pas une nécessité...
    [ NDLR : bah oui, ne respectons pas les normes et faisons tous dans tambouille dans notre coin... utile pour communiquer entre nous ! ]

    Mathieu ‏@oustedaisse :
    @agence_avicom @lechat_et_moi non mais si vous foutez n'importe quoi dans la zone DNS il est normal que ça marche pas !! Et c'est le cas !

    avicom ‏@agence_avicom :
    @oustedaisse on a du avoir de la chance avec tous nos autres sites. Merci

    Mathieu ‏@oustedaisse :
    @agence_avicom a votre place je regarderai quand même http://www.zonemaster.net/test/3841  avant d'accuser les mauvaises personnes ;)

    avicom ‏@agence_avicom :
    @oustedaisse initialement on accuse personne, le faite est que ça bloque uniquement chez les utilisateurs Free

    Mathieu ‏@oustedaisse :
    @agence_avicom les NS Free (idem Google DNS) cherchent a valider la signature du champ DS. Si invalide > servfail cf http://bit.ly/17mnBCp  »

    Sources :
    https://twitter.com/bortzmeyer/status/570611097696378880
    https://twitter.com/bortzmeyer/status/570611239526768642
    https://twitter.com/bortzmeyer/status/570614987326169090
    https://twitter.com/bortzmeyer/status/570618916025835520
    https://twitter.com/agence_avicom/status/567617305065295874
    February 26, 2015 at 10:19:44 AM UTC - permalink - https://twitter.com/bortzmeyer/status/570611097696378880
  • Ansible, Chef, Puppet… Pourquoi ça ne juste marche pas :(
    « Imaginons avoir une infrastructure de notre parc informatique basée sur la virtualisation, ie. chaque service isolé dans son propre conteneur.
    A minima, on va vite se retrouver avec les conteneurs suivants : un Bind9, un Postfix, un Nginx, un Apache, un MySQL, un PostgreSQL…
    Gestion des rôles

    Tout comme dans un vrai code informatique, on voudrait profiter de mécanisme d'héritage, de polymorphisme et d'agrégation pour définir notre infrastructure, afin d'éviter la duplication et de conserver une base robuste à un changement future d'infrastructure.

    On doit pouvoir définir une description globale de tous les Apache (installation et configuration de Apache, ouverture des ports 80 et 443 du pare-feu, installation de RPaf…) et faire apparaître la notion de rôle.

    On veut quand même vouloir en redéfinir certains morceaux machine par machine (liste des virtualhosts servis, déploiement des certificats SSL…), un peu à la manière d'un héritage

    On doit pouvoir agréger les rôles, et signaler qu'un serveur Apache est aussi un serveur de courriel, par composition.
    Gestion des relations

    Tous les services d'une infrastructure sont inter-dépendants : le Nginx sert de reverse-proxy au serveur Apache, qui sert un site web qui utilise une base de données PostgreSQL, le Nginx a donc besoin de l'adresse IP du serveur Apache et des virtualhosts servis, le Apache a besoin de l'IP du serveur MySQL.
    Pire, les dépendances forment des boucles : le serveur Apache a besoin de l'IP du serveur Nginx devant lui pour configurer son module RPaf (qui permet d'avoir l'IP réelle du client dans les logs et non celle du reverse-proxy), le MySQL a besoin de l'IP du serveur Apache pour ouvrir son pare-feu…

    On a donc besoin de pouvoir définir son infrastructure d'une manière déclarative (le quoi) et non impérative (le comment), en évitant la redondance de l'information (l'IP d'une machine définie une et une seule fois), la duplication de code, le risque d'incohérence dans la configuration en cas de modification de l'infrastructure…
    Dans l'exemple précédent, on veut ne définir les IP que dans la description de l'hôte en question, et ne définir qu'à un seul endroit la relation entre un Apache et son proxy Nginx.

    Pour les relations, on aimerait même se minimiser le travail au cas où notre infrastructure soit amenée à évoluer demain, et donc pouvoir les définir de manière complexe, comme par exemple « un Nginx proxite tous les virtualhost des Apaches situés sur la même machine physique », et non se contenter de déclarer le proxy Nginx utilisé dans le descriptif du Apache, ou à l'inverse la liste de tous les Apache proxifiés dans le descriptif du Nginx (mais surtout pas les deux sous peine d'incohérence !)
    Gestion des tâches

    On doit faire le déploiement et la configuration en elle-même. Installation de paquets, édition de fichiers de configuration, création d'un utilisateur, redémarrage d'un service… L'outil doit fournir des primitives basiques et si possible avec une couche d'abstraction suffisante pour être indépendant de l'OS utilisé (on installe un paquet avec apt sous Debian mais avec yum sous Red-Hat).

    Et comme dans un langage informatique, il doit être possible de combiner ces primitives pour obtenir des résultats plus complexes. Par exemple, créer un administrateur, c'est créer un utilisateur, déployer sa clef SSH sur son compte et la déployer aussi sur le compte root.

    [...]

    Puppet : ça ne marche pas

    [...]

    Pour un service donné, l'outil fait clairement bien son job. On peut installer des paquets, déployer des fichiers tout fait ou via un template instancié à la volée avec les valeurs nécessaires. Le DSL est plutôt assez concis et donne des descriptifs faciles à lire une fois passé l'apprentissage des incantations magiques.

    Là où ça commence à pécher, c'est pour la gestion des relations… Puppet est basé sur un mécanisme client/serveur, ou plus exactement master/slave. Une machine, le puppet master, contient l'intégralité des descriptifs, rôles, fichiers et autres templates. Sur chaque machine gérée par l'outil tourne en permanence un démon puppet, le puppet agent, qui vient régulièrement vérifier s'il a des choses à faire, une fois par jour par exemple.
    Du coup, chaque machine est isolée et ne peut travailler qu'avec ce qui lui est directement destiné. Une machine n'a pas la possibilité d'aller voir ce qu'une autre machine a déployé, par exemple un Nginx ne peut pas lister les Apaches sous sa responsabilité, c'est à l'administrateur de lui indiquer explicitement la liste quelque part, ce quelque part devant obligatoirement être dans le périmètre du Nginx et pas uniquement dans celui des Apaches. Bref, c'est à l'administrateur de gérer manuellement les dépendances, sans aucune assistance de la part de l'outil pour lui dire qu'il a oublié de renseigner le nouvel Apache fraîchement arrivé dans la configuration du Nginx !
    [...]

    Pour palier à ce problème, il existe quand même un mécanisme de partage d'information, les ressources exportées.
    On veut par exemple que chaque installation d'un serveur Apache génère automatiquement une vérification Nagios sur le port 80.

    [...]

    Déjà, on vient de devoir créer une nouvelle classe de serveurs, nagios::target::apache. Pourtant, un serveur HTTP est juste un serveur HTTP. Pas un serveur HTTP + vérification du port 80. On a introduit de la redondance d'information…
    Qui dit redondance dit erreur possible. Je définis un nouveau serveur Apache dans mon infra mais je suis un jeune admin tout fraîchement démoulu de l'école ? Je n'ai pas les 10 ans d'historique et d'expérience de mes collègues ? Ben on m'a demandé d'installer un nouveau serveur Apache, donc j'ai juste mis la classe apache à ma nouvelle machine… et elle n'est donc pas monitorée par Nagios !
    Le simple fait d'avoir un port 80 en écoute devrait automatiquement entraîner le monitoring ! Parce que si l'admin sys en chef passe sous un poney demain et qu'il y a toutes les chances du monde qu'il soit le seul à avoir conscience qu'il y a un Nagios mort dans un coin, plus personne ne pensera à le faire !

    [...]

    La redondance appelant généralement à toujours plus de redondance, que se passe-t-il si on souhaite maintenant monitorer le port 80 et le port 443 ? Pas de soucis, il n'y a qu'à rajouter une vérification du port 443 dans la classe nagios::target::apache. Oh mais attendez, si mon serveur Apache n'a que du HTTP ou que du HTTPS ? Ah mais les tests Nagios vont se mettre à échouer sur le port non présent… Pas grave, il n'y a qu'à faire 2 classes, nagios::target::http et nagios::target::https et le tour est joué ! Ah mais oui, j'ai aussi un Munin tient. Ok, ben disons « munin::target::http » et « munin::target::https ».
    On voit bien le risque de fonctionner ainsi : à chaque modification de l'infrastructure, comme les dépendances ont été codées « à la main » dans l'outil, rien ne s'adapte tout seul, et toute modification devient intrusive… Un simple serveur Apache qui devrait n'avoir qu'une seule classe apache va se retrouver avec une foultitude de classes présentes uniquement dans un but technique et non métier.

    [...]

    En plus, on ne parle ici que d'une dépendance simple qui devrait en réalité s'exprimer ainsi : « j'active une vérification Nagios sur le port 80 si la machine possède la classe apache ou nginx et au moins un virtual-host sur le port 80 ».
    Imaginez maintenant devoir régler de cette manière une dépendance plus complexe de type « déploie des virtual-host nginx en reverse proxy pour chaque virtual-host de chaque Apache présent sur la même machine physique que toi, en utilisant comme IP de proxy l'IP du Apache ». Je vous tend déjà le tabouret et la corde…

    [...]

    Chef : ça ne marche pas non plus

    [...]

    Là où tout change c'est que Chef fournit de base une base de données Solr qui va stocker l'intégralité de la description d'une machine. Cette base est bien entendue requétable depuis les descriptions, ce qui permet de faire des choses assez sympathiques pour régler les problèmes précédents. [...] Par rapport à Puppet, on a aussi la notion de databags, qui permettent de séparer proprement la partie données de la partie traitement. Une telle séparation est très difficile à atteindre avec Puppet.

    [...]

    J'ai uniquement éditer les fichiers de données (databag), qui ne sont pas liés à une recette et peuvent donc contenir pas mal d'information, pour y ajouter les clefs SSH à déployer ainsi que les IP autorisées pour les accès SSH.
    Et la recette ssh va utiliser exactement le même jeu de données que la recette users, pour déployer tout ça proprement et remplir les fichiers de clefs et la config SSH. Impact sur la recette users : 0 ! Impact sur les anciennes classes des serveurs : 0 ! Ce qui n'aurait très clairement pas été le cas avec du Puppet (ajout d'une ressource exportée toute moche ou refacto lourde de l'infra pour introduire des classes fantômes) ! On obtient donc des configurations bien plus claires d'un point de vue sémantique avec Chef qu'avec Puppet.
    Tout ça grâce à la primitive search, qui va interroger la base de données Solr pour récupérer l'état de la configuration. Ce truc est extrêmement utile et fait toute la différence avec Puppet, l'intégralité de la configuration est accessible depuis n'importe quelle recette, ce qui évite la duplication d'information et/ou la création de classes fantômes pour gérer les dépendances. La recette Nginx passera par search pour lister les Apache de sa machine hôte (search(:node, "apache:* AND physical:#{node[:physical]}")), ou encore la recette DNS l'utilisera de la même manière pour récupérer l'IP du DNS tournant sur le même réseau pour renseigner resolv.conf.
    Chef, vainqueur par KO…

    [...]

    Le problème avec search, c'est que les données sont publiées dans la base Solr non pas quand vous les publiez sur le serveur Chef mais après l'exécution de l'agent Chef… Et ça change tout…
    Chef utilisant un agent sur chaque machine, on n'a aucun moyen de garantir l'ordre d'exécution du déploiement. Si par malheur le Nginx passe avant les Apaches, la config vue par Nginx est l'ancienne config et ne tient pas compte des potentielles modifications introduites par l'admin ! Pire, Chef a tendance à effacer toutes les configs existantes quand un admin publie ses modifications, le prochain passage sur le Nginx va donc virer tous les virtualhost de proxy et les Apaches vont se retrouver coupés du monde !
    On pourrait résoudre ce problème en désactivant tous les agents et en exécutant le passage de Chef « à la main », via un script qui ordonne correctement les machines à déployer et s'y connecte dans l'ordre via SSH par exemple. Ça ne résoud qu'une partie du problème car dans le cas d'une boucle de dépendances (Nginx proxite les Apaches qui ont besoin de l'IP du Nginx), il faudrait passer plusieurs fois sur chaque machine et avec des recettes différentes pour parvenir à avoir le bon résultat.

    [...]

    Ansible : et ben… ça ne marche pas mieux…

    [...]

    D'abord, je n'ai pas trouvé comment définir des méta-taches, ie. une tache réutilisable qui appelle plusieurs sous-taches. Typiquement, ma tache de création d'un utilisateur (humain) est décomposable en création d'un utilisateur (UNIX) et déploiement de sa clef SSH. La création d'un administrateur est la création d'un utilisateur (humain) et déploiement de sa clef SSH pour root.

    [...]


    Bon, continuons… Les groupes maintenant… J'ai dit un peu plus haut que les variables pouvaient être héritées via les variables de groupe. Mais Ansible a un concept d'héritage somme toute assez intéressant. [...] Naïvement, j'ai voulu faire des choses comme ça. Naïvement hein, vu que c'est juste une description de ce qu'est réellement mon infra…
    Toutes mes machines qui ont du SSH doivent avoir le port SSH d'ouvert. Toutes les machines qui font du Apache doivent avoir le port HTTP et HTTPS d'ouvert, ont pour adresse mail de contact une certaine chose commune et servent leur contenu depuis /srv/www. Et enfin, toutes les machines Apache derrière le même proxy Nginx seront configurées toutes pareilles niveau RPAF.

    [...]

    Voilààààààààà… L'héritage au sens Ansibli-ien du terme, c'est « Zyva, pourquoi j'ai déjà une valeur moi ? Allez zou, fait pas suer, j'écrase ! ». Du coup, j'en suis réduit à calculer moi-même le résultat du merge que j'aurais envie d'avoir eu, et à le coller dans le hosts_var/www.yml et à supprimer tous les groups_var. Très pratique le jour où il y a un paramètre commun à changer…

    [...]

    Dans mon déploiement, le service fail2ban restart nécessaire à la prise en compte des nouvelles règles de blocage de fail2ban est en réalité fait via un service firewall restart, vu que le firewall doit déployer des règles avant celle de fail2ban. J'ai donc besoin de faire [...] Question à 10 balles : où et comment je peux faire pour mutualiser le Restart firewall et ne définir sa tache associée qu'à un seul et unique endroit (principes KISS et DRY) ? [...] Bam… Ça passe très bien à l'exécution de la tache firewall mais ça plante violemment à celle de fail2ban, comme quoi le handler est manquant. Bon ok, j'ai peut-être été un peu vache avec toi Ansible, j'vais quand même te mettre le handler dans un truc un peu plus commun et pas directement dans le role firewall…

    [...]

    Mais en fait, non, j'ai fait une erreur, je n'ai pas tous mes serveurs qui déploient du fail2ban, mais juste ceux avec ssh. Gros naïf va… [...] Wait ? Wat ‽ J'ai bien lu ? C'est une blague à ce niveau-là, non ? Elle est où la caméra ? J'vais quand même pas devoir déclarer dans chaque groupe/rôle/whatever le role common juste pour avoir des handlers qui sont déjà théoriquement communs à toutes les machines, si ?

    Bref… Pour conclure, alors que Ansible me semblait assez prometteur et intéressant sur ses concepts (agentless + ssh + DSL pas trop dégeu), je me retrouve à devoir quasiment réfléchir à la place de l'outil pour lui prémâcher tout le travail, un peu comme si vous aviez une super machine sensée faire le café mais où vous deviez la remplir avec du café déjà tout fait qu'elle n'a plus qu'à réchauffer pour servir…

    [...]

    Ansible n'est qu'un outil pour orchestrer séquentiellement des tâches d'administration et non pas un outil de gestion de configurations comme prétendent l'être chef et puppet. »
    February 25, 2015 at 11:55:58 PM UTC - permalink - https://blog.imirhil.fr/ansible-chef-puppet-pourquoi-ca-ne-juste-marche-pas.html
  • « François contre Internet ». - Le Hollandais Volant
    « le nouveau jeu télévisé : François contre Internet.

    Le principe est simple : François jette un dé et en fonction du résultat, on utilise un prétexte pour faire chier les internautes. Je rappelle la règle :

    Le dé tombe sur :
        * 1 ou 4, le prétexte est le terrorisme ;
        * 2 ou 5, le prétexte est la pédophilie ;
        * 3 ou 6, le prétexte est l’antisémitisme.
    [NDLR : il est nul ce jeu : il manque propriété intellectuelle et

    *François jette le dé*

    Et ce sera… un 6, l’antisémitisme ! Bravo François ! On applaudit bien fort.

    Donc voilà, notre gagnant repart avec 3 lois destinées à stigmatiser l’Internet comme responsable de l’antisémitisme.
    François, je vous le rappelle, s’est déjà servi de son joker 49/3, mais il lui reste l’avis du public qu’il n’a toujours pas utilisé depuis 2012 ! Quel courage ce François. »

    Oui, il faut aussi savoir en rire sinon c'est la déprime (principe/définition du lulz : combattre en rigolant aussi). Si en plus cettte image drôle peut aider à diffuser l'info, ce n'est que du positif.
    February 25, 2015 at 4:33:31 PM UTC - permalink - http://lehollandaisvolant.net/?d=2015/02/24/17/35/11-francois-contre-internet
  • bird-config - Forge de la Fédération FDN
    De la conf' BIRD utilisée en prod' chez Gitoyen.
    February 25, 2015 at 10:22:56 AM UTC - permalink - https://code.ffdn.org/gitoyen/bird-config
Links per page: 20 50 100
◄Older  
page 260 / 306
Newer►
Mentions légales identiques à celles de mon blog | CC BY-SA 3.0

Shaarli - The personal, minimalist, super fast, database-free, bookmarking service by the Shaarli community